Introduction
L’apprentissage automatique (mieux connu sous son nom anglais machine learning, souvent abrégé en ML), est un sous-domaine de l’intelligence artificielle visant à entrainer des modèles prédictifs à partir de données. Ces données d’entrainement comportent généralement un ensemble de variables (X) (aussi appelées attributs, features, ou encore data matrix) utilisées en entrée du modèle et une variable cible (y) que le modèle va essayer de prédire à partir des (X). La variable cible (y) peut être aussi bien continue (tâche de régression) que catégorielle (tâche de classification).
Prenons un exemple illustratif, où une banque voudrait estimer le risque de crédit d’un client à partir de ses caractéristiques. Pour ce faire, elle possède un ensemble de données historiques de clients pour lesquels le risque de crédit est déjà connu. Elle peut donc se servir de ces données pour entrainer un modèle de machine learning qui prédit le risque (y) sur base des caractéristiques (X) des clients :
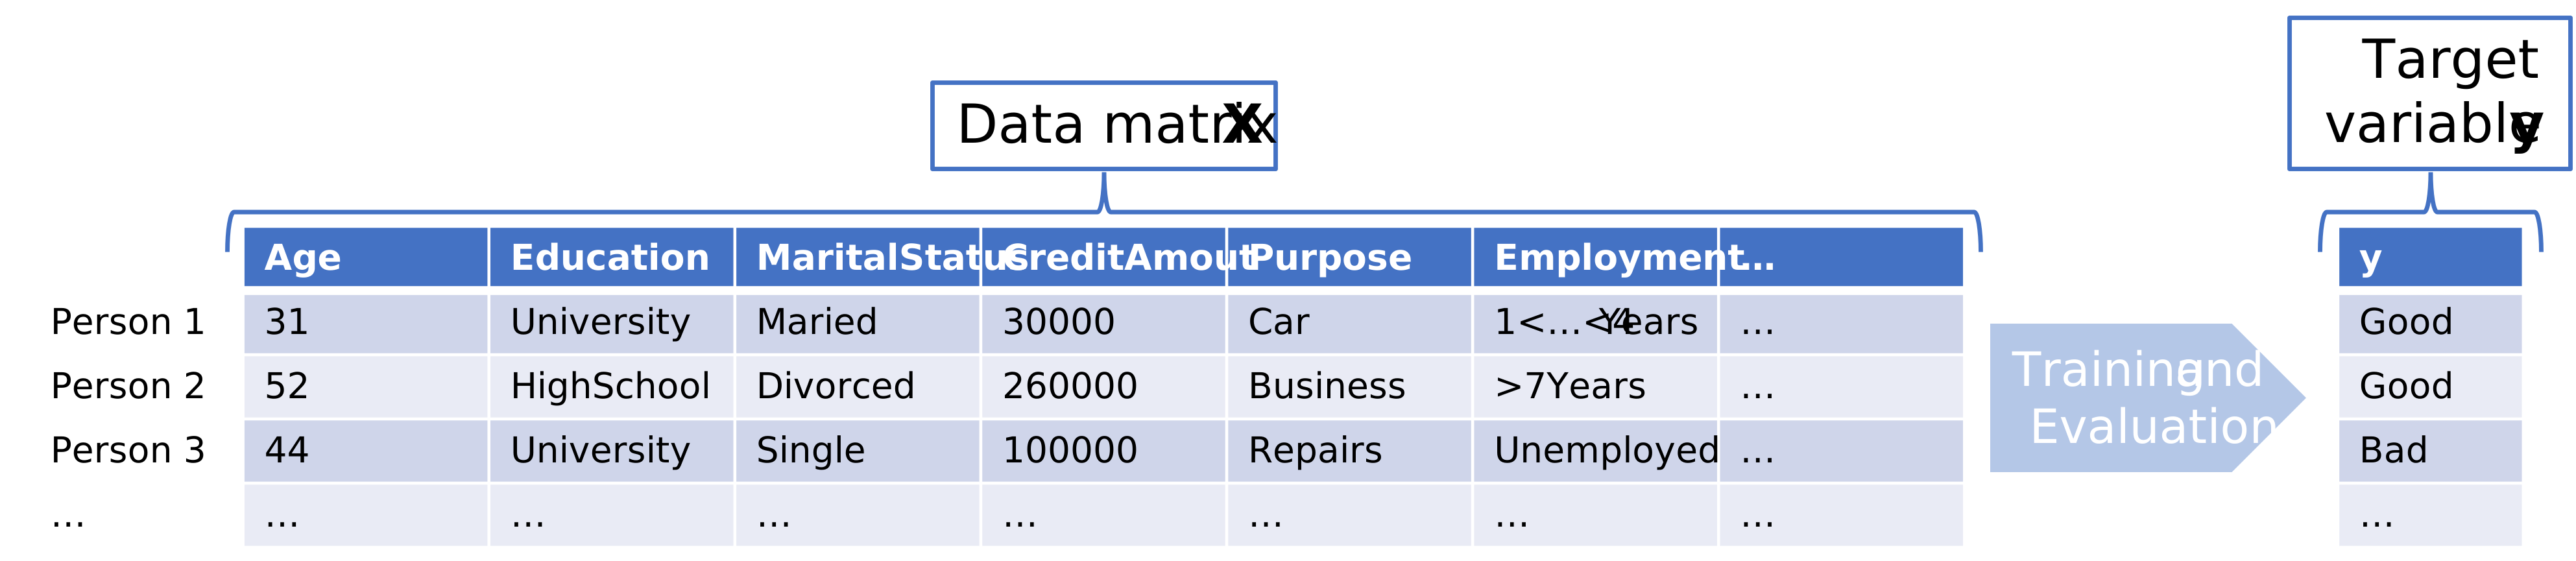
Figure 1 : Illustration de l’entrainement d’un modèle de machine learning (classification)
Une fois le modèle entrainé, celui-ci peut être utilisé pour estimer le risque de crédit d’autres clients (pour lesquels ce risque n’est pas encore connu) à partir de leurs caractéristiques :

Figure 2 : Utilisation du modèle entrainé pour prédire le risque de nouveaux clients
Le machine learning est un outil puissant qui permet d’entrainer un modèle prédictif de manière purement empirique, à partir des motifs (patterns) qui peuvent être identifiés dans les données. Cependant, puisque le machine learning traditionnel se base sur des données tabulaires, celui-ci ne permet pas de travailler directement sur des données interconnectées, structurées en réseau (voir ci-dessous).
Dans cet article, nous allons donc nous intéresser à la problématique du machine learning sur ce type de données et, plus précisément, à ce que l’on appelle réseaux de neurones sur graphe et leurs applications.
Le machine learning et les données structurées en réseau
Prenons un second exemple pour illustrer la problématique. Supposons un modèle ayant pour objectif d’analyser un réseau social (tel que Facebook), par exemple pour identifier si un utilisateur est légitime ou s’il s’agit d’un faux compte/d’un bot. Dans la Figure 3, chaque utilisateur est représenté par un cercle et dispose d’attributs (variables socio-démographiques, statistiques d’utilisations de la plateforme, etc.), représenté par un une rangée de cases bleues. Deux cercles sont connectés par un arc si les utilisateurs correspondants sont amis sur la plateforme.
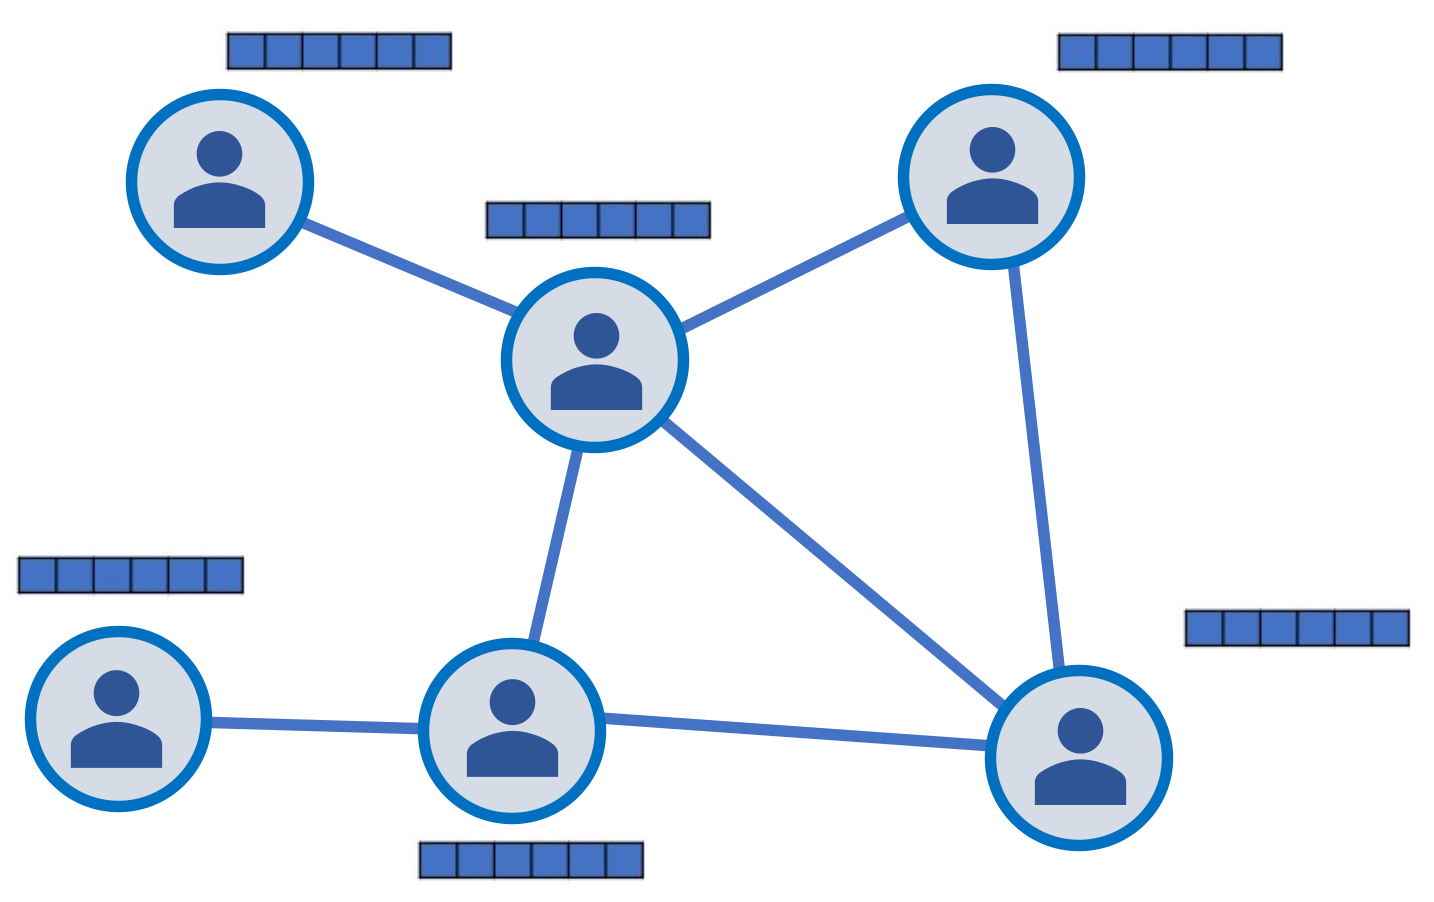
Figure 3 : Représentation d’un petit réseau social, avec des attributs sur chaque utilisateur
Puisque les modèles de machine learning travaillent sur des données tabulaires, une approche naïve pour entrainer un modèle prédictif serait simplement de prendre les attributs des utilisateurs et les arranger sous la forme d’une table (où chaque colonne représente un attribut et chaque ligne un utilisateur), et d’entrainer un modèle de ML sur cette table, comme nous l’avons vu précédemment dans la Figure 1.
Cependant, avec cette approche, les liens/connexions entre utilisateurs sont simplement ignorés, et toute l’information que ces liens pourraient contenir ne sera pas prise en compte par le modèle. Or, ces connexions constituent souvent une source précieuse d’informations. Nous avons pu le voir dans deux articles de blogue dédiés à la détection de fraude [1 , 2] : dans le domaine de la détection de fraude sociale, connecter les entreprises entre elles (notamment lorsqu’elles ont des chantiers en commun/employés en commun) permet souvent de révéler des réseaux de fraude qui n’auraient pas pu être identifiés en analysant simplement les caractéristiques des entreprises.
Dès lors se pose une question : comment réussir à prendre en compte ces connexions dans le modèle prédictif ? La solution se trouve dans l’analyse de graphes.
Pour rappel, un graphe est une structure mathématique composée d’un ensemble de nœuds, interconnectés par des liens appelés des arcs (voir notre article sur le sujet). En considérant que chaque nœud du graphe représente une entité (par exemple : une personne) et chaque arc représente une relation entre ces entités, le réseau peut être analysé avec des outils d’analyse de graphe. Dans cet article, nous utiliserons d’ailleurs les termes « réseau » et « graphe » de manière interchangeable.
La première approche, assez simple et intuitive, pour capturer les connexions dans le modèle prédictif consiste simplement à appliquer des algorithmes de graphes sur le réseau (voir notre article sur les technologies de graphe), afin de générer de nouveaux attributs à partir des interconnexions (approche « featurization »). Cela permet d’enrichir les données tabulaires avec de nouvelles variables issues d’une autre source d’information : les connexions entre entités (voir Figure 4 pour illustration). Il s’agit d’une technique que nous avons déjà mentionné dans cet article de blog.
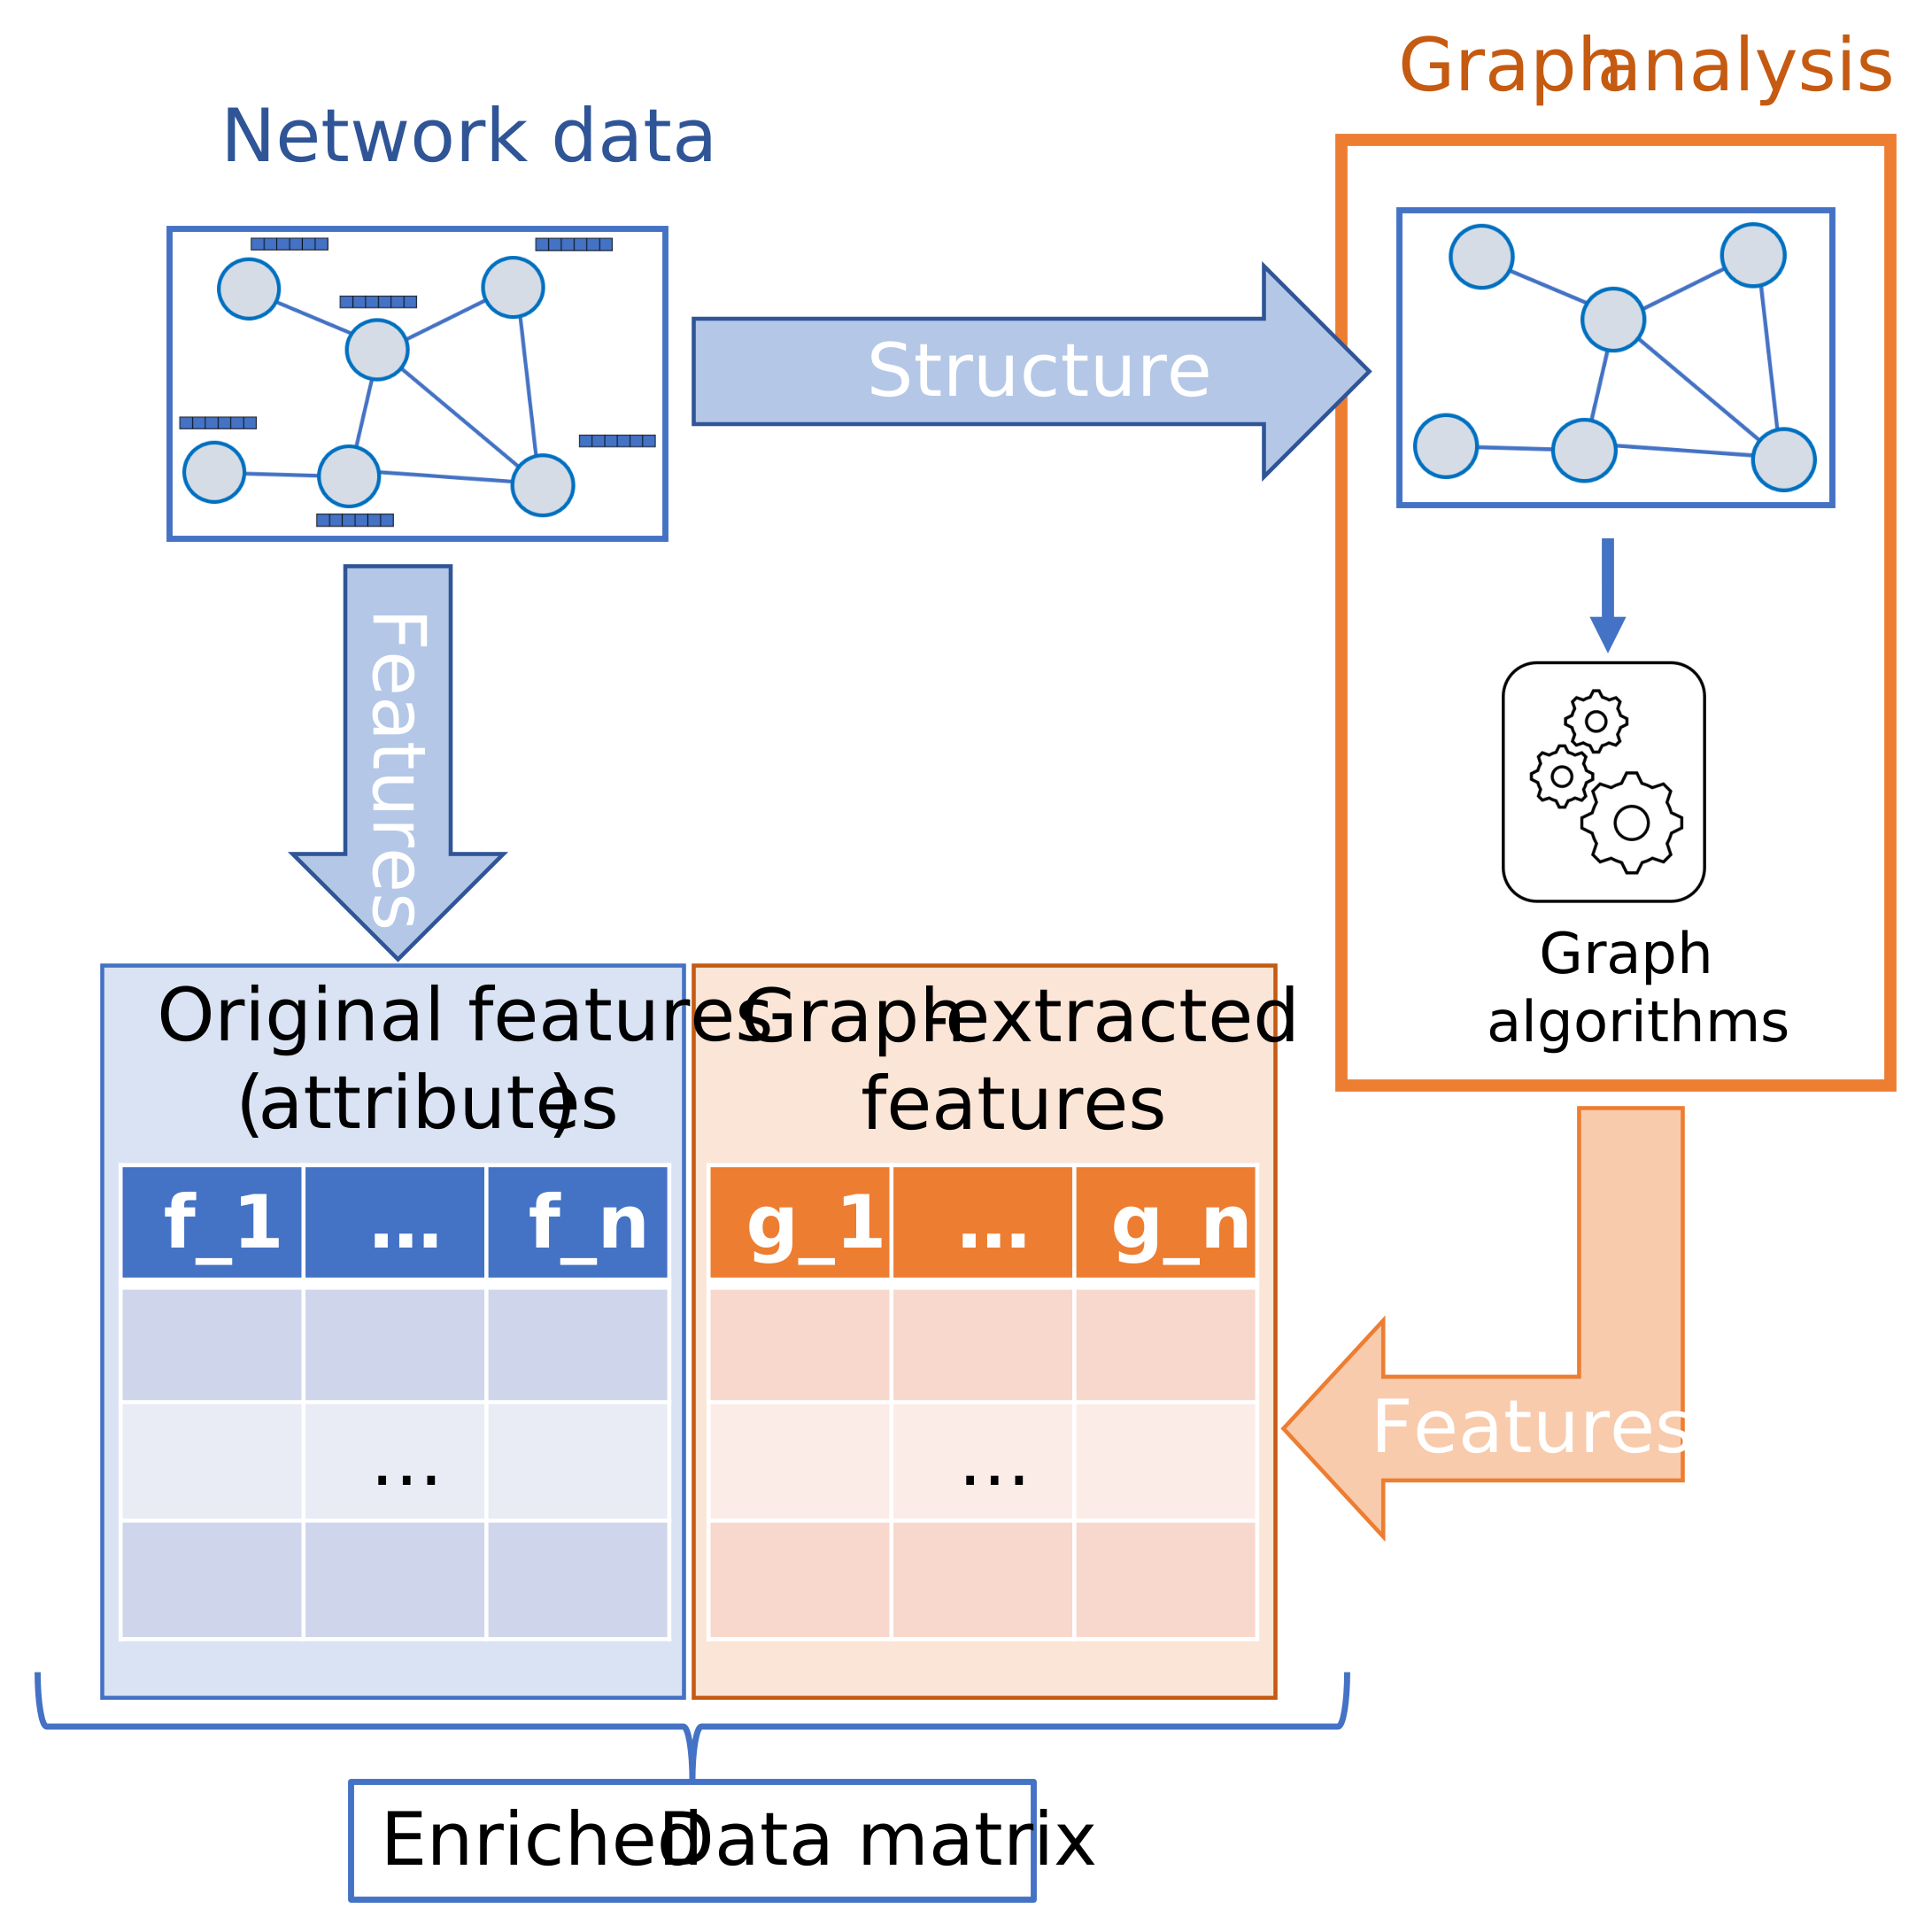
Figure 4 : Enrichir les données tabulaires via une featurization des interconnexions
Dans cet article nous allons plutôt investiguer une autre approche. Plutôt que d’enrichir les données tabulaires avec des nouvelles variables issues du graphe, nous allons nous intéresser à un modèle prédictif spécifiquement prévu pour l’analyse de données en réseau : le réseau de neurones sur graphe (plus connu sous son nom anglais graph neural network, ou simplement GNN).
Les graph neural networks
Concepts de base
L’objectif d’un GNN est assez simple : calculer, pour chaque nœud du réseau, une représentation vectorielle () qui résume le nœud. La représentation du nœud va ensuite pouvoir être utilisée pour obtenir une prédiction () pour , via une fonction prédictive .
Dans sa forme la plus simple la représentation () du nœud est donc simplement les attributs de , à savoir (l’approche naïve vue précédemment). L’objectif du GNN sera donc de calculer une représentation plus riche, qui résumera à la fois les caractéristiques de l’observation, mais aussi des informations sur son environnement dans le réseau. Pour ce faire, le GNN va calculer ces représentations de manière itérative en utilisant les liens du réseau pour transférer de l’information entre les nœuds.
Illustrons ce processus de manière visuelle :
Etape 1 : Initialisation des représentations
La première étape consiste simplement à initialiser les représentations en utilisant les attributs des observations .
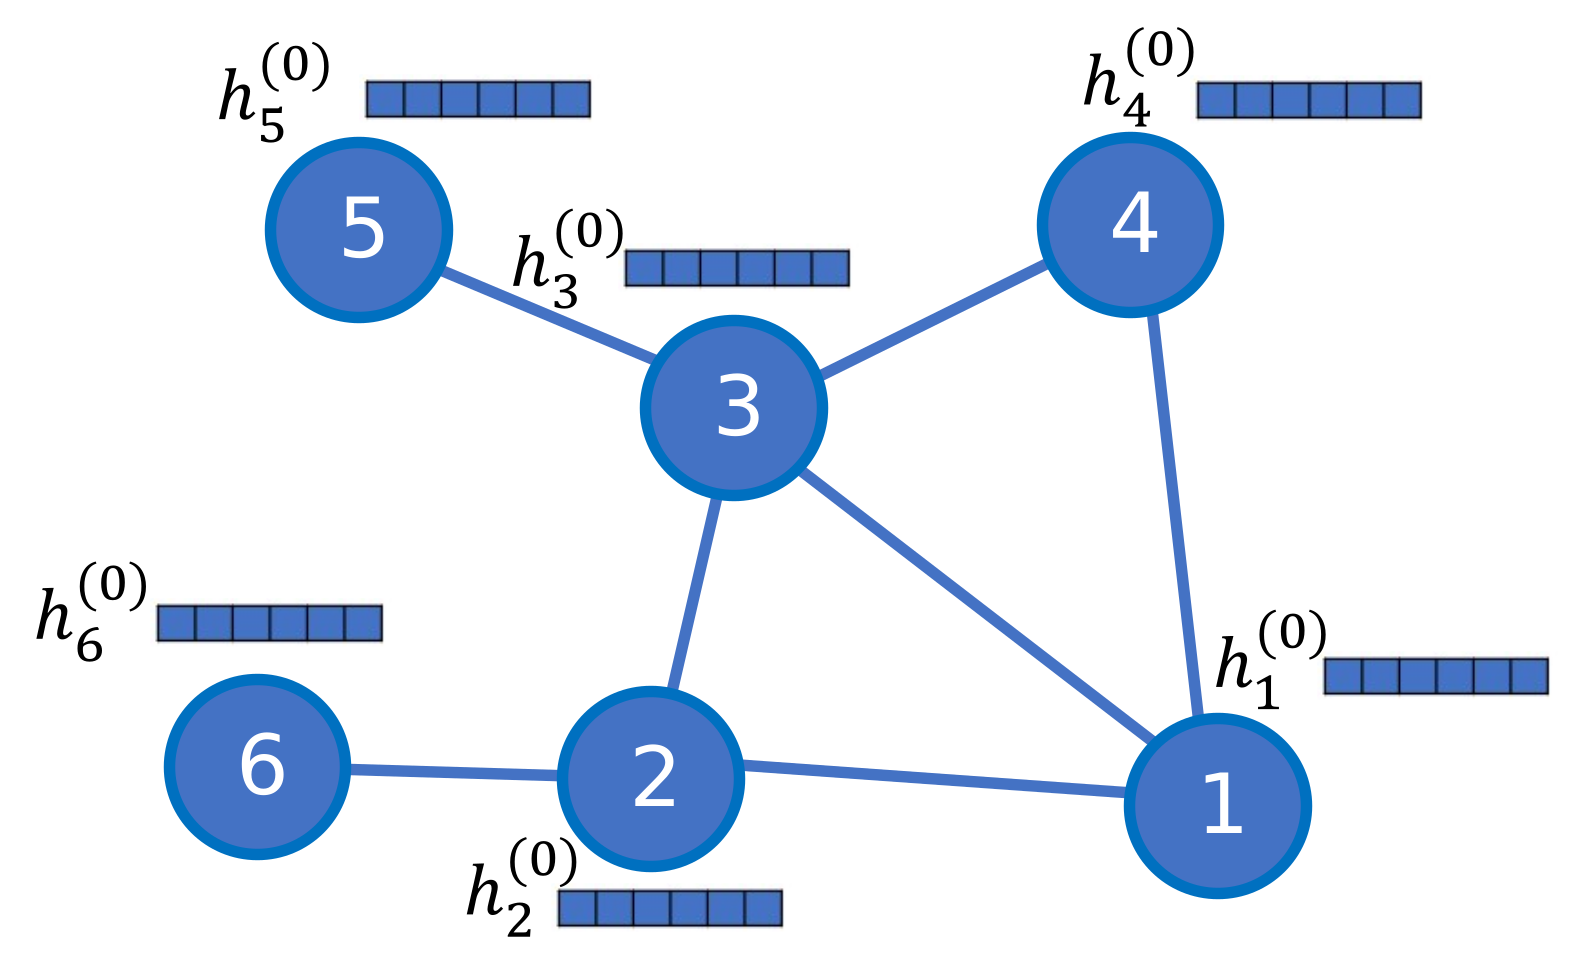
Figure 5 : Initialisation d’un GNN
Etape 2 : Transfert de l’information (message passing)
La seconde étape est le calcul itératif des représentations. Pour ce faire, les représentations à l’itération () sont utilisées pour calculer les représentations de l’itération suivante ().
Cette mise à jour des représentations se fait en propageant l’information entre nœuds, via les liens du réseau.
Illustrons cela avec le nœud 1 : Afin de mettre à jour sa représentation (), le GNN utilise l’information des nœuds adjacents (connectés au nœud 1), ici en l’occurrence il s’agit des nœuds 2, 3 et 4 (voir Figure 5 ci-dessus). Le GNN récupère donc leurs représentations actuelles , et , et les agrège. L’agrégation peut être toute simple, comme par exemple prendre la moyenne des représentations, ou leur somme. Cette représentation agrégée est ensuite combinée à la représentation du nœud lui-même (), pour obtenir la nouvelle représentation (). En bref, cette nouvelle représentation du nœud 1 () contient désormais un mélange entre les informations du nœud lui-même et les informations agrégées de ses voisins directs. Ce processus est illustré dans la Figure 6 ci-dessous :
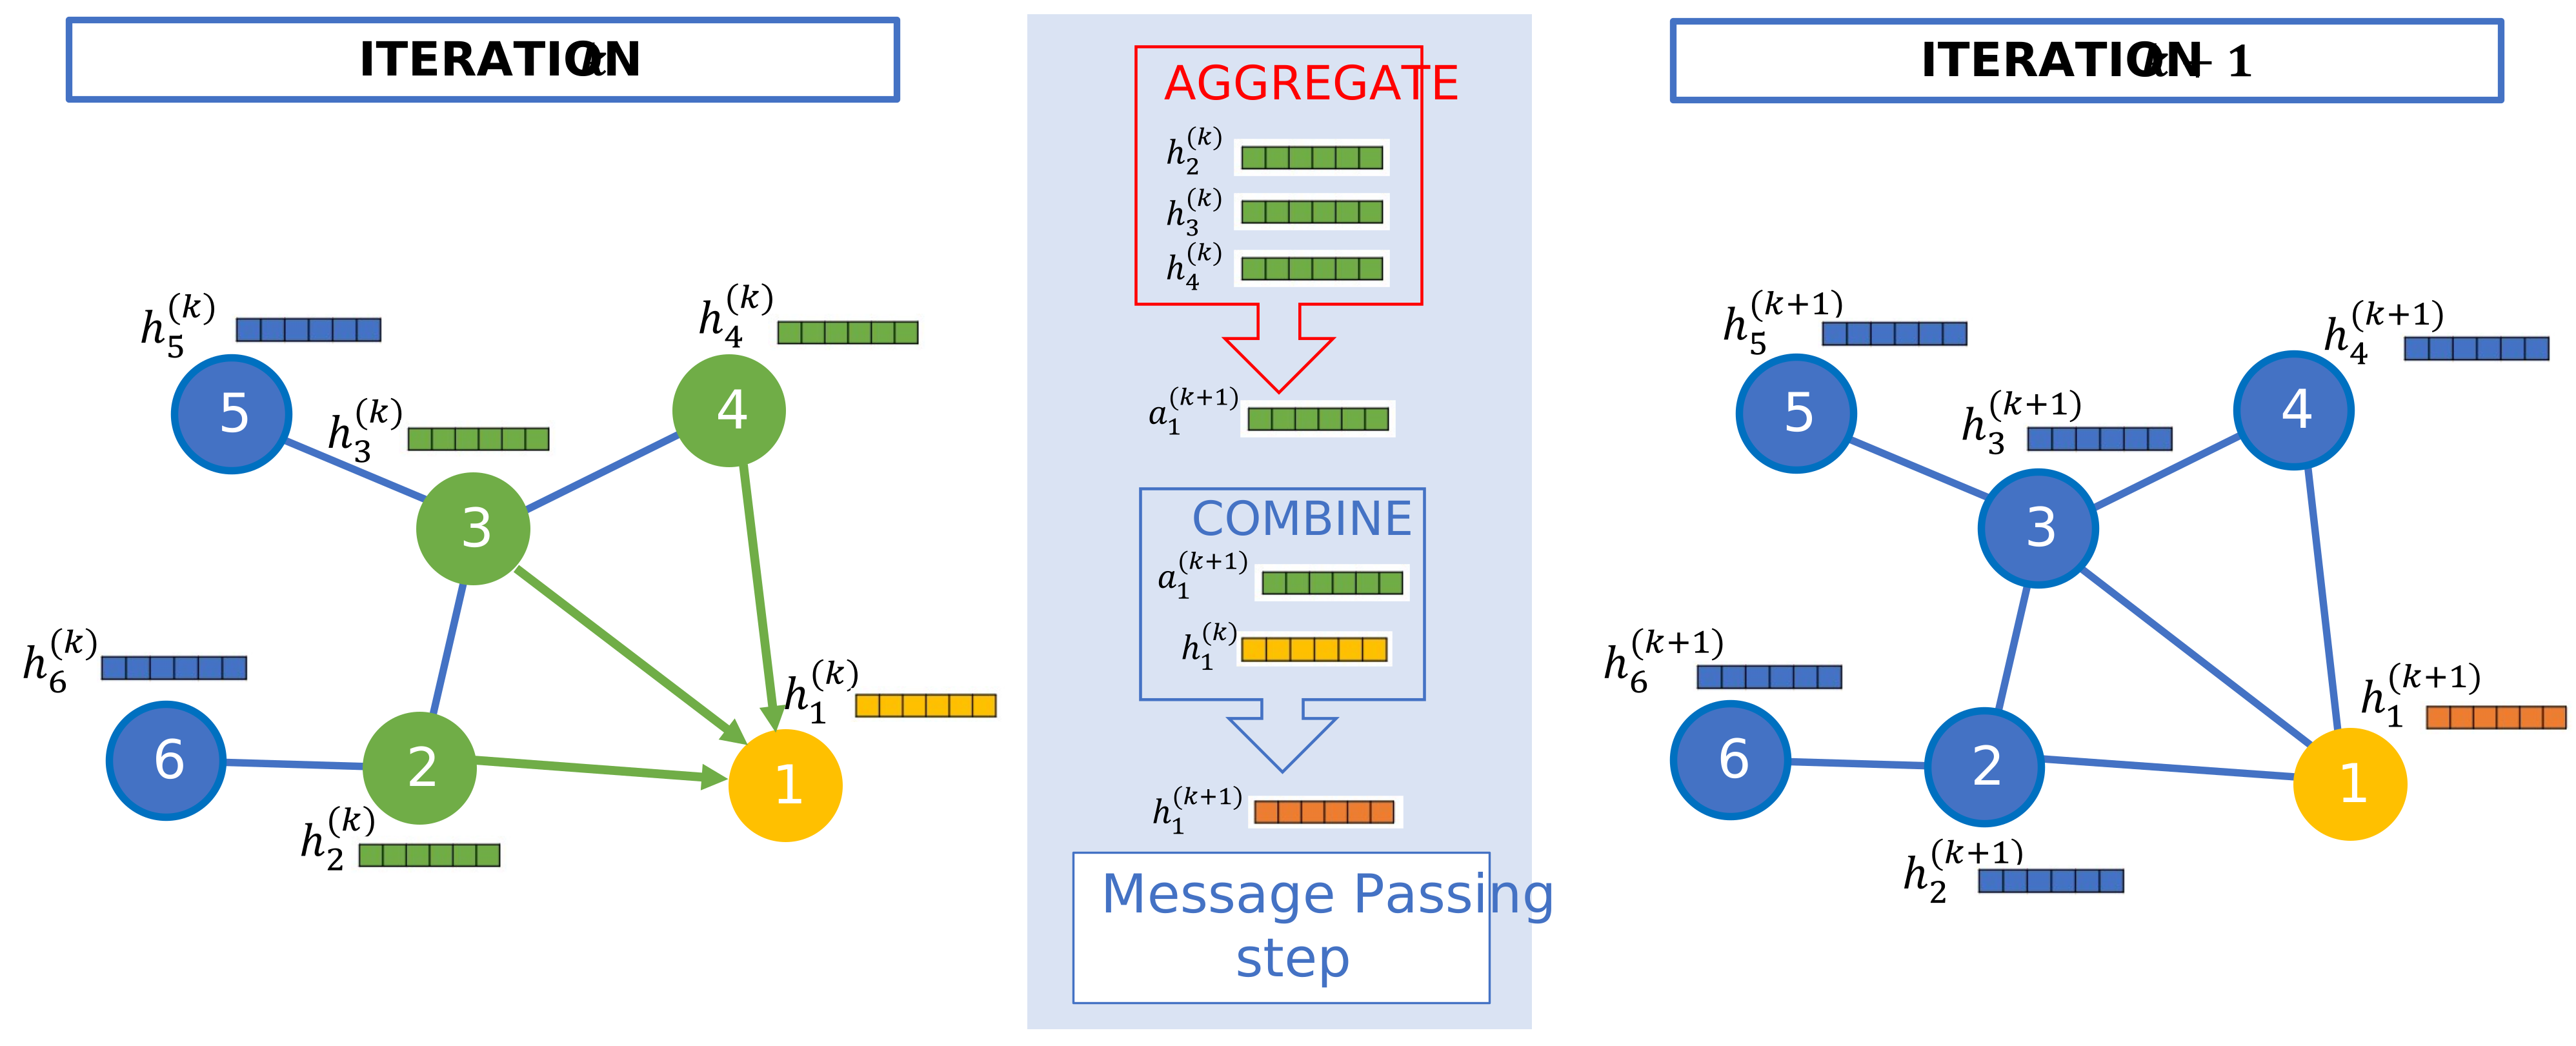
Figure 6 : Illustration d’un message passing pour mettre à jour le nœud 1
Le processus que nous venons d’illustrer ici (avec le nœud 1) est réalisé simultanément sur tous les nœuds du graphe, afin de mettre à jour leur représentation respective, et s’appelle une étape de message passing.
Un GNN est une suite d’étapes de message passing, ou chaque itération utilise la représentation de l’itération précédente. Le GNN va donc réaliser () étapes de message passing, au terme desquelles la représentation contiendra un résumé de l’information du nœud et de son entourage (direct et indirect) dans le graphe.
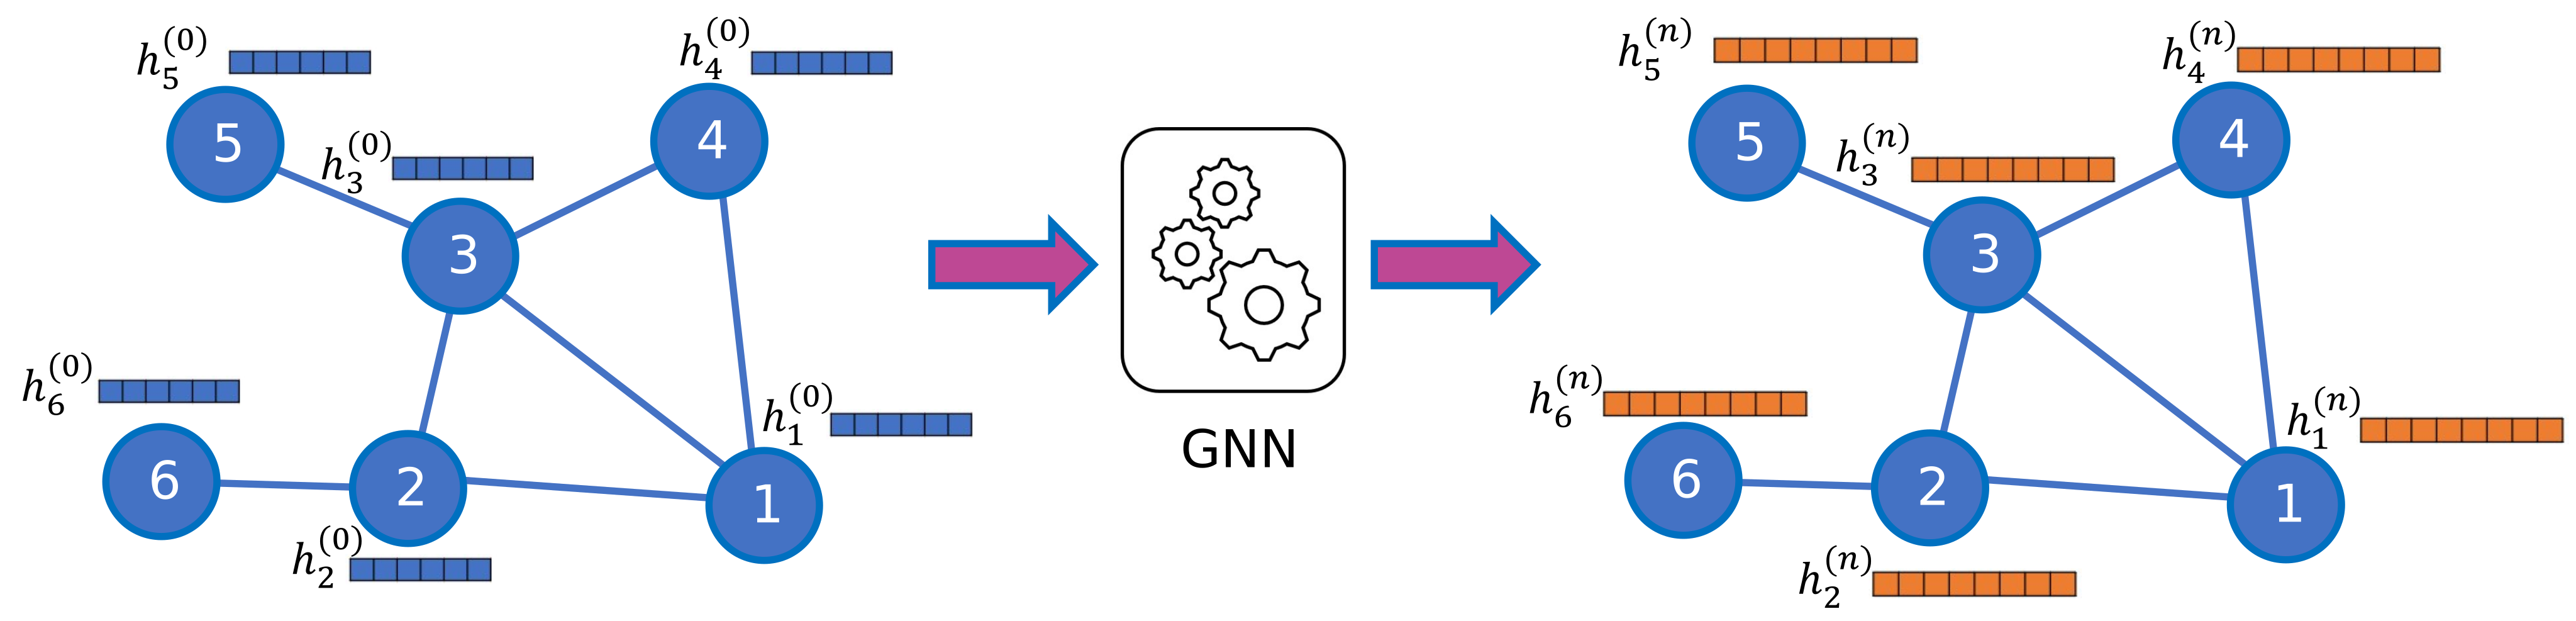
Figure 7 : Représentation des nœuds d’un réseau via un GNN
Etape 3 : Finalisation
La représentation finale () de chaque nœud correspond à la représentation obtenue à la dernière couche du GNN (itération ), à savoir : pour tout nœud , la représentation est simplement .
Qu’est ce qui rend un GNN puissant ?
Bien évidemment, la vision du message passing que nous avons présentée ici est fortement simplifiée. Dans la pratique, ce qui donne toute sa force à un GNN, c’est la présence dans chaque étape de message passing, d’une matrice de coefficients qui va pondérer le transfert d’information. Les coefficients de cette matrice peuvent être ajustés afin de modifier (et donc, d’optimiser) ce transfert d’information. Il est intéressant de noter qu’il ne s’agit pas d’une matrice globale, réutilisée à chaque itération, mais bien d’une matrice de coefficients distincte par itération de message passing.
Puisque les prédictions finales du modèle () sont basées sur les représentations () construites par le GNN, l’erreur de prédiction (entre la valeur prédite et la vraie valeur) peut être calculée et utilisée par le GNN pour optimiser les coefficients contenus dans ses matrices (rétropropagation). Cela permet au GNN d’améliorer la qualité de ses représentations.
En d’autres termes, le GNN ne construit pas une représentation générique des nœuds, mais bien une représentation « sur-mesure », optimisée spécifiquement afin d’être la plus pertinente possible pour la tâche considérée, obtenue à partir des caractéristiques de chaque nœud et de son entourage dans le réseau.
De plus, chaque message passing utilise aussi une fonction d’activation, qui applique une transformation non-linéaire à la sortie de chaque message passing. Grâce à cette fonction d’activation, le GNN peut apprendre des relations non linéaires complexes dans ses représentations.
Les applications du GNN
Cette représentation sur-mesure fait du GNN un outil très polyvalent, pouvant être utilisé dans une très grande variété d’applications. Comme nous en avons discuté précédemment, un GNN peut être utilisé comme un outil pour faire des prédictions (aussi bien pour des tâches de classification que de régression) au niveau des nœuds, par exemple en détection de fraude [3, 4], mais son utilisation n’est pas limitée aux prédictions sur les nœuds.
Le GNN peut aussi être utilisé pour faire des prédictions au niveau des liens. Réaliser une prédiction sur un lien se fait à partir de la représentation des deux nœuds qui y sont associés. Il peut s’agir soit de faire une prédiction sur un lien déjà existant (prédire une caractéristique associée à un lien) soit de prédire des liens qui n’existent pas encore (par exemple : pour faire des suggestions d’amis sur un réseau social, recommander un produit/un contenu sur une plateforme d’e-commerce, etc.).
Enfin, le GNN est aussi souvent utilisé pour faire des prédictions au niveau du graphe entier. Une application bien connue des GNN pour ce type de tâche est l’analyse de molécules [5]. Pour ce faire, chaque molécule est représentée sous forme d’un graphe, où chaque nœud est un atome (avec des attributs tels que le numéro atomique, la chiralité, la charge formelle, etc.), et les liens entre les nœuds représentent les liaisons chimiques entre les atomes au sein de la molécule. Au lieu d’avoir un grand graphe unique, on a ici un ensemble de « petits » graphes, où chaque graphe représente une observation pour laquelle on veut une prédiction. Dans notre exemple, chaque graphe représente une molécule, composée d’atomes interconnectés, et on veut obtenir une prédiction par molécule, par exemple pour répondre à des questions du type : « est-ce que la molécule est toxique ? » ou « est-elle soluble dans l’eau ? ».
Pour réaliser ce type de prédiction (au niveau du graphe), il faut cependant ajouter une opération supplémentaire dans le GNN, située après les étapes de message passing, afin de passer d’une représentation au niveau de chaque nœud à une représentation globale au niveau du graphe entier (voir Figure 8). Cette opération est communément appelée « readout », ou encore parfois « graph-level pooling ». Une étape de readout peut être vue comme une sorte d’agrégation de toutes les représentations des nœuds du graphe.
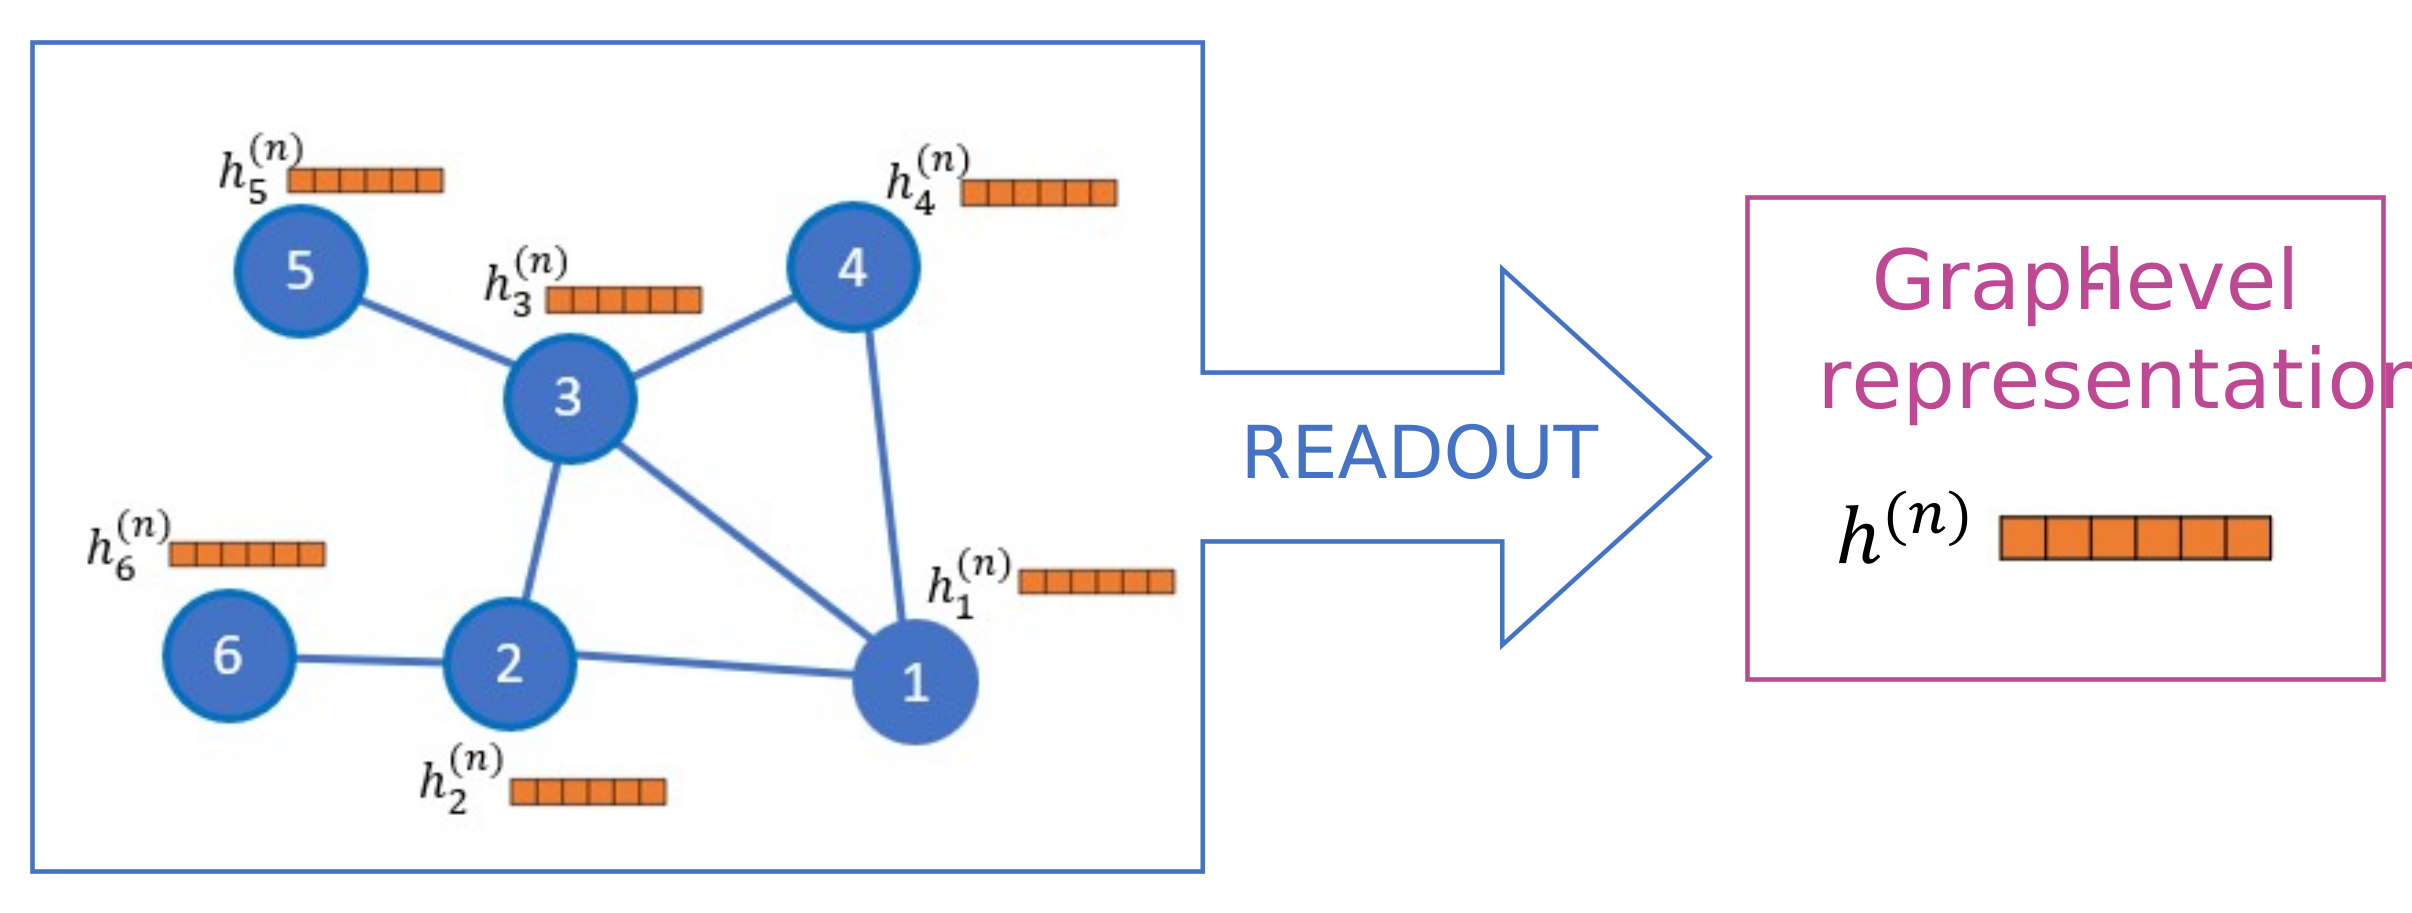
Figure 8 : Etape de readout d’un GNN pour obtenir une représentation vectorielle du graphe entier
Dans notre exemple d’analyse de molécule, le GNN va donc permettre de générer une représentation riche de chaque molécule, comprenant à la fois les informations sur les atomes qui la composent et sur les liaisons chimiques qui la structurent.
Interprétabilité d’un GNN
Nous l’avons vu, la force d’un GNN est sa capacité à extraire une représentation complexe pour chaque nœud (ou pour le graphe entier), optimisée pour être la plus pertinente possible pour la tâche à résoudre.
En contrepartie, cela limite fortement l’interprétabilité du modèle. En effet, les représentations élaborées par le GNN, qui sont utilisées pour les prédictions, sont une sorte de « condensé » d’informations relatives à une entité et son voisinage (direct et indirect) dans le réseau. Le résultat : un vecteur d’informations compressées, optimisé pour être très efficace une fois utilisé comme input dans un modèle prédictif, mais complètement incompréhensible pour un humain.
Afin de pouvoir comprendre les décisions d’un GNN, il faut alors se baser sur des méthodes d’explainable AI (XAI), qui est un domaine de l’intelligence artificielle visant à rendre des modèles prédictifs (souvent « black-box ») interprétables et compréhensibles pour des humains. L’une des méthodes les plus connues d’XAI pour les GNN est le GNNExplainer [6] (voir Figure 9). Supposons qu’un modèle prenne une décision pour laquelle on souhaite une explication (par exemple, un nœud pour lequel le modèle a fourni une prédiction), le GNNExplainer a pour objectif de déterminer quelles parties du réseau (Figure 9 A) et quels attributs sur les nœuds (Figure 9 B) ont joué un rôle prédominant dans la construction de la prédiction.
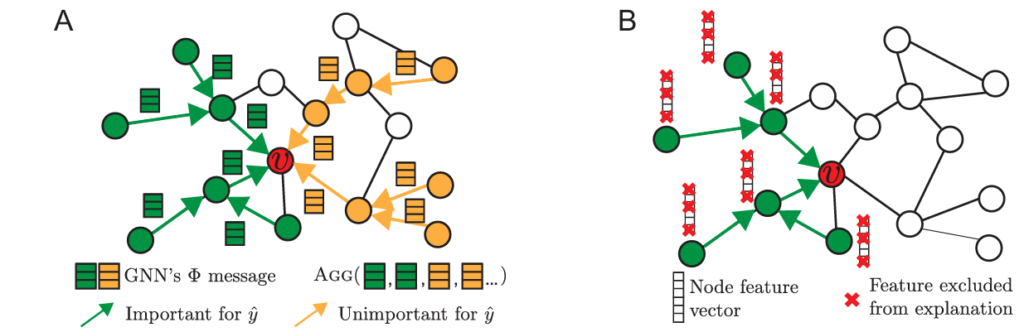
Figure 9 : Fonctionnement du GNNExplainer (image extraite de [6])
Conclusion
Les GNN sont des réseaux de neurones spécialement conçus pour l’analyse de données structurées sous forme de graphe En exploitant les relations entre les nœuds, ils permettent la propagation et l’agrégation d’informations à travers la structure du graphe. Ils ont pour objectif d’apprendre des représentations riches et pertinentes des nœuds, des arcs ou du graphe dans son ensemble, selon la tâche considérée.
Comme nous l’avons vu, il s’agit de modèles très polyvalents, pouvant s’utiliser dans de nombreuses tâches (prédiction au niveau d’un nœud, d’une relation, ou du graphe entier). Dans cet article nous n’avons présenté qu’un seul exemple de GNN, il en existe de nombreux autres.
Au final, les GNN partagent beaucoup d’avantages (et aussi d’inconvénients), avec les réseaux de neurones artificiels classiques. Ce sont des outils puissants, utilisables dans un grand nombre d’applications, mais ils sont complexes et doivent être conçus et entrainés précautionneusement.
[1] Blog Smals Research – Un fraudeur ne fraude jamais seul
[2] Blog Smals Research – Un fraudeur ne fraude jamais seul, partie 2
[3] Motie, S., & Raahemi, B. (2024). Financial fraud detection using graph neural networks: A systematic review. Expert Systems with Applications, 240, 122156.
[4] Mardani, S., & Moradi, H. (2024). Using graph attention networks in healthcare provider fraud detection. IEEE Access, 12, 132786-132800.
[5] Wu, Z., Ramsundar, B., Feinberg, E. N., Gomes, J., Geniesse, C., Pappu, A. S., … & Pande, V. (2018). MoleculeNet: a benchmark for molecular machine learning. Chemical science, 9(2), 513-530.
[6] Ying, Z., Bourgeois, D., You, J., Zitnik, M., & Leskovec, J. (2019). Gnnexplainer: Generating explanations for graph neural networks. Advances in neural information processing systems, 32.