
Interests: Network analytics, Graph Databases, GIS (spatial) Analytics, Fraud Detection, Data visualisation, Data Sciences, Data quality, Email reliability, Social Media.
Publications
-
Data quality : mesurer la similarité interne
Dans notre article précédent, nous présentons une méthode permettant de mesurer et visualiser l’importance des valeurs rares dans une liste de données où l’on s’attend à une grande redondance, souvent signes d’un problème de qualité. La méthode en question se basait uniquement sur un comptage des occurrences des valeurs, sans du tout en examiner le contenu. Classiquement, pour standardiser des…
-

Scrapy – web scraping framework
Scrapy est un framework écrit en (et pour) Python permettant de faire du web-crawling (ou web-scraping), c’est-à-dire de l’extraction automatique de contenu à partir de pages web. Une grande partie du travail du web-crawling est gérée automatiquement par le framework. Pour des cas simples mais réalistes, le code (Python) à écrire peut se limiter à quelques lignes de code. Nous…
-
Data Quality : mesurer les valeurs rares
Des données, à partir du moment où elles vivent et sont alimentées, souffrent presque systématiquement de problèmes de qualité. Le domaine de la Qualité des données (Data Quality) est vaste, très actif tant dans le monde académique qu’industriel. Il y a bien évidemment des aspects méthodologiques (améliorer les processus pour que les données qui rentrent soient les plus “propres” possible),…
-
Sept (bonnes) raisons d’utiliser une Graph Database
Ces dernières années, les bases de données orientées graphes (ou Graph DB, présentées dans nos blogs précédents [1, 2]), et plus généralement les bases de données NoSQL, ont énormément gagné en popularité et en visibilité. Pour preuve, Neo4j, le leader actuel du marché des Graph Databases, apparaît depuis 2014 dans le “Magic Quadrant for Operational Database Management Systems (DBMS)“, et…
-
Jupyter Notebook – Environnement interactif de programmation
Jupyter Notebook, projet Open Source issu de IPython, est une application web destiné à offrir un environnement interactif dans plusieurs dizaines de langages de programmation (dont, à l’origine, Julia, Python et R, d’où le nom JuPyteR), particulièrement adapté à l’analyse de données (data science). Contrairement à la programmation traditionnelle (séquentielle), où on exécute un programme en démarrant toujours du même…
-
Le marché du travail salarié en Belgique : une analyse réseau (partie 3/3)
Dans le premier article de notre série consacrée à l’analyse réseau du marché du travail en Belgique, nous avons présenté les données constituant le graphe (ou réseau) de Dimona, sur lequel se base cette série de trois articles, et montré quelques métriques, permettant par exemple d’évaluer le nombre de personnes actives à un moment donné, ou le nombre d’employeurs par…
-
Le marché du travail salarié en Belgique : une analyse réseau (partie 2/3)
Dans notre article précédent, nous avons montré quelques éléments d’analyse réseau appliquée à la base de données “Dimona”, qui recense, en Belgique, les relations de travail entre tous les employeurs et leurs employés. Nous y avons principalement analysé la notion de degré, permettant de voir le nombre d’employeurs par employé, et le nombre d’employés par employeur. Nous allons maintenant examiner…
-
Le marché du travail salarié en Belgique : une analyse réseau (partie 1/3)
Le marché du travail nécessite partout une attention constante de la part des autorités. Cette attention ne peut se faire qu’en ayant une connaissance descriptive approfondie du secteur, raison pour laquelle de nombreuses analyses statistiques sont faites en permanence dans ce domaine (ONSS, Statbel, SPF Emploi, Actiris…). Si ces analyses sont incontournables, nous avons montré dans nos précédents blogs [à…
-
Gérer les doublons dans une Graph Database
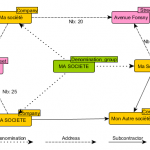
Dans nos blogs précédents (1, 2, 3, 4), nous avons mis en évidence le fait que les structures de graphes étaient très adaptées à la recherche de comportement frauduleux. En étant plongés quotidiennement dans des données issues de diverses bases de données officielles, nous sommes également confrontés en permanence à la présence d’une grande quantité d’information de mauvaise qualité (1,…
-

Fighting Fraud with Graph Databases
Slides presented at Devoxx 2017. Graphs are everywhere: When it comes to representing relationships between entities, there is no better mathematical model so far. Classical “SQL” databases perform very poorly in modeling complex relationships, both in terms of response time and in writing (queries) time. Graph database have been designed to tackle those limitations and excel in many domains, such…
Keywords:
analytics Artificial intelligence big data blockchain BPM chatbot cloud computing cost cutting cryptography data center data quality EDA egov Event GIS governance Information management Machine Learning Managing IT costs methodology Mobile Open Source Privacy Productivity quantum computing Security social software design software engineering standards