data quality
-
Rencontre « Data quality » FNRS-ULB-Smals le 30/01/2014 à l’Université Libre de Bruxelles
La prochaine réunion du groupe de contact FNRS « Analyse critique et amélioration de la qualité de l’information numérique » se tiendra le jeudi 30 janvier 2014 à 14h00 à l’Université Libre de Bruxelles (salle Solvay, bâtiment NO, 5ème étage, campus de la Plaine). L’accès à la rencontre, qui est financée par le Fonds National de la Recherche Scientifique, est…
-
Une adresse e-mail pour chaque citoyen ?
Lors de l’étude que nous avons menée sur la qualité des adresses e-mails dans une série de bases de données des administrations et qui a déjà mené à trois articles de ce blog (1, 2, 3), mettant en évidence la grande difficulté à maintenir une adresse e-mail correcte pour chaque citoyen, une question nous a à plusieurs reprises été posée :…
-
Vérifier une adresse e-mail : un problème facile ? Partie III
Contrôler qu’un e-mail a bien été consulté n’est pas une chose facile, et dans le meilleur des cas, ne pourra être fait qu’avec un degré de certitude très peu élevé. En général, dans les sociétés qui utilisent un gestionnaire d’envoi de campagne de marketing (CRM) à la pointe de la technologie, utilisant les techniques de validation les plus avancées, ce…
-
Vérifier une adresse e-mail : un problème facile ? Partie II
Nous avons vu dans l’article précédent comment vérifier qu’une adresse électronique était susceptible d’exister, en en vérifiant la syntaxe, ou, autrement dit, qu’elle était grammaticalement correcte. Nous y avons montré que, pour faire les choses le plus précisément possible, et donc éliminer d’entrée de jeu un maximum d’adresses erronées, la problématique était bien plus complexe qu’imaginée généralement. Bien sûr, dans un…
-
“Data Virtualization” : perspectives et points d’attention
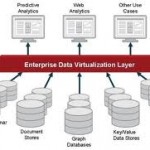
L’approche “Data Virtualization” émerge depuis quelques années dans la littérature et sur le marché IT (voir par exemple : R. F. Van der Lans, “Data Virtualization for BI Systems. Revolutionizing Data Integration for Datawarehouse“, Morgan Kaufmann, Elsevier, 2012). A l’heure du “Big Data“, cette approche propose de séparer couches physiques, logiques et conceptuelles, pour faciliter l’accès aux données via la modélisation d’une…
-
De la production industrielle à la production d’information : analogies, paradoxes et enseignements opérationnels
Les normes internationales actuelles en matière de “data quality” puisent leur origine au début du XXème siècle, dans la foulée de la révolution industrielle et du taylorisme, alors que la production et le montage en grande série réclament l’interchangeabilité des pièces. Aussi a-t-on recours au travail “à tolérances”, dans le cadre duquel les dimensions des pièces usinées peuvent varier dans des limites définies…
-
Vérifier une adresse e-mail : un problème facile ?
Gérer un carnet d’adresse électronique personnel peut sembler un problème assez facile. Finalement, on a surtout besoin d’avoir une adresse correcte pour ceux à qui on écrit fréquemment, et pour ces contacts-là, on prend vite conscience de l’obsolescence d’une adresse « e-mail » (ou courriel, pour emprunter un joli terme à nos amis Québécois). Mais lorsqu’il s’agit de gérer des listes de dizaines…
-
“Mapping the World of Data Problems” : la qualité des données vue par la communauté IT
En novembre 2012, O’Reilly Media a édité un “livre-événement” en matière de “data quality” : Q. E. McCallum, Bad Data Handbook, Mapping the World of Data Problems, O’Reilly Media, 2012, 246 p. Cet ouvrage collectif sur la qualité des données est inédit car il émane exclusivement de la communauté des web software developpers (Python, Perl script, Parallel R, NLP, cloud computing, …),…
-

Data tracking – le “Return On Investment” de l’analyse des flux d’information
L’egovernment repose sur la gestion de vastes bases de données dont les enjeux sont stratégiques sur les plans sociaux, financiers et juridiques. Ces bases de données sont alimentées par des flux d’information (entre citoyens, entreprises, employeurs et administrations) véhiculant un grand nombre d’anomalies formelles (valeurs déviantes par rapport aux valeurs attendues) dont la gestion est coûteuse. Le « data tracking…
-
Améliorer la qualité de l’information : du “stemma codicum” au “data tracking”
Au Moyen-âge, le processus de transformation de l’information, avant l’invention de l’imprimerie, se déployait de siècles en siècles avec les générations de moines copistes. Afin d’établir l’appareil critique d’un manuscrit (dont on dispose souvent de multiples copies divergentes et dont on a parfois perdu l’original), l’historien construit un stemma codicum (généalogie des données), technique d’analyse comparative des variantes empruntée à…
Keywords:
analytics Artificial intelligence big data blockchain BPM chatbot cloud computing cost cutting cryptography data center data quality EDA egov Event GIS governance Information management Machine Learning Managing IT costs methodology Mobile Open Source Privacy Productivity quantum computing Security social software design software engineering standards