data quality
-
Géocodage : contourner les lacunes d’OpenStreetMap (partie 2)
Dans notre article précédent, nous présentions les difficultés que nous avons rencontrées dans notre tentative de géocoder (convertir une adresse en coordonnées géographiques, et standardiser cette adresse) avec Nominatim, le géocodeur d’OpenStreetMap. Nous avons aussi évoqué qu’en modifiant légèrement les adresses que Nominatim n’avait par reconnues, elles le devenaient. Nous avons considéré un ensemble de modifications, que nous appelons ci-dessous…
-
Géocodage : contourner les lacunes d’OpenStreetMap (partie 1)
Pour divers clients, nous avons été à la recherche d’une solution permettant de nettoyer (standardiser) des adresses postales, principalement en Belgique. Nous avions besoin d’une solution « on-premise », idéalement en Open-Source. Nous avons voulu construire une solution basée sur OpenStreetMap, qui permettait de rencontrer ces deux contraintes. Mais il s’est vite avéré qu’OpenStreetMap n’était pas très robuste aux erreurs…
-
« I want to talk to a HUMAN! » : impact de la qualité des bases de connaissances sur les chatbots (29/01/2020, ULB)
Rencontre « Data quality » FNRS-ULB-Smals le 29/01/2020 à l’Université libre de Bruxelles La prochaine réunion du groupe de contact FNRS « Analyse critique et amélioration de la qualité de l’information numérique » se tiendra le mercredi 29 janvier 2020 dès 13h30 à l’Université libre de Bruxelles (auditoire AY2.108, bâtiment A, campus du Solbosch). Pluridisciplinaire, le groupe se situe au confluent des sciences appliquées et des sciences humaines et politiques. La…
-
Data quality : mesurer la similarité interne
Dans notre article précédent, nous présentons une méthode permettant de mesurer et visualiser l’importance des valeurs rares dans une liste de données où l’on s’attend à une grande redondance, souvent signes d’un problème de qualité. La méthode en question se basait uniquement sur un comptage des occurrences des valeurs, sans du tout en examiner le contenu. Classiquement, pour standardiser des…
-
Data Quality : mesurer les valeurs rares
Des données, à partir du moment où elles vivent et sont alimentées, souffrent presque systématiquement de problèmes de qualité. Le domaine de la Qualité des données (Data Quality) est vaste, très actif tant dans le monde académique qu’industriel. Il y a bien évidemment des aspects méthodologiques (améliorer les processus pour que les données qui rentrent soient les plus “propres” possible),…
-
Anomalies & Transactions Management System (ATMS) : enjeux, concepts, réalisations et travail en cours
Cet article de blog a pour objet d’introduire le concept d’ATMS (Anomalies & Transactions Management System) : après en avoir montré l’importance fondamentale dans le cadre du « back tracking » récemment évoqué dans un article de blog de mai 2018, nous en rappelons les principales références ; nous en évoquons ensuite les concepts généralisables, le ROI, l’originalité ainsi que les premières implémentations d’envergure…
-
Cours-conférence “Data Quality Tools”, ULB, 13 mars 2019, par Gani Hamiti, Smals
Gani Hamiti donnera un cours-conférence à l’ULB le 13 mars 2019 de 18 heures à 20 heures, suivi d’une réception. Dans le cadre du cours STIC-B-510 « Qualité de l’information et des documents numériques » de la filière STIC de l’Université libre de Bruxelles, Gani Hamiti, Data Quality Analyst chez Smals, donnera un cours-conférence intitulé « Data Quality Tools : concepts and practical lessons from a vast operational…
-
Data Quality & « back tracking » : depuis les premières expérimentations à la parution d’un Arrêté Royal
Thomas Redman compare une base de donnée à un lac, alimenté par des flux aquatiques continus. La métaphore illustre l’approche qui sera évoquée dans ce blog en vue d’améliorer la qualité des données. 1. Les enjeux de la qualité des données : rappel et exemple En effet, nettoyer “à l’infini” le fond du lac (via des algorithmes de “data cleansing”) n’est pas efficace…
-
La préservation du patrimoine scientifique à l’heure du numérique (31/01/2018, ULB)
Rencontre « Data quality » FNRS-ULB-Smals le 31/01/2018 à l’Université libre de Bruxelles La dernière réunion du groupe de contact FNRS « Analyse critique et amélioration de la qualité de l’information numérique » a eu lieu mercredi 31 janvier 2018 à l’Université libre de Bruxelles (auditoire AY2.108, bâtiment A, campus du Solbosch). Téléchargez les slides d’Isabelle Boydens (1MB) et d’Anthony Leroy (16MB). Pluridisciplinaire, le groupe se situe au confluent…
-
Gérer les doublons dans une Graph Database
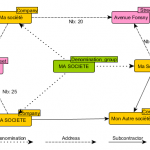
Dans nos blogs précédents (1, 2, 3, 4), nous avons mis en évidence le fait que les structures de graphes étaient très adaptées à la recherche de comportement frauduleux. En étant plongés quotidiennement dans des données issues de diverses bases de données officielles, nous sommes également confrontés en permanence à la présence d’une grande quantité d’information de mauvaise qualité (1,…
Keywords:
analytics Artificial intelligence big data blockchain BPM chatbot cloud computing cost cutting cryptography data center data quality EDA egov Event GIS governance Information management Machine Learning Managing IT costs methodology Mobile Open Source Privacy Productivity quantum computing Security social software design software engineering standards