RAG
-

Agentic RAG : quand un agent en vaut-il la peine ?
Un agent fournit-il de meilleures réponses lorsqu’il est interrogé sur une base de connaissances interne ? Nous avons comparé un système RAG basique et un système RAG agentique dans le cadre d’un cas d’usage concret. Découvrez les résultats ici.
-
Agentic RAG: wanneer loont een agent de moeite?
Levert een agent betere antwoorden op bij vragen over een eigen knowledge base? We vergeleken basic RAG met agentic RAG op een concrete use case. Ontdek hier de resultaten.
-

Garde-fous : délimitez votre IA
Les garde-fous contribuent à la sûreté et à la fiabilité des applications d’IA. Découvrez comment dans cet article.
-
Guardrails: hou je AI binnen de lijntjes
Guardrails helpen AI-toepassingen veiliger en betrouwbaarder te maken. Ontdek hier hoe.
-
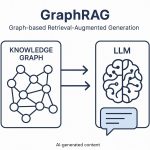
GraphRAG – Naar een verbeterde retrieval dankzij knowledge graphs
RAG-systemen (Retrieval-Augmented Generation) hebben het mogelijk gemaakt voor grote taalmodellen (LLM’s) om te steunen op betrouwbare gegevens. Maar ze blijven onder andere beperkt in hun vermogen om hallucinaties te beheersen. Daar komt GraphRAG in beeld: door LLM’s te combineren met knowledge graph verbetert het de nauwkeurigheid, transparantie en redeneercapaciteit van de modellen.
-
Expériences pratiques avec l’évaluation automatique de la RAG
La qualité est le principal obstacle à la mise en production d’applications LLM. Dans cet article de blog, nous examinerons dans quelle mesure la qualité des applications RAG peut être mesurée automatiquement.
-
Praktische ervaringen met automatische RAG-evaluatie
Kwaliteit is dé bottleneck om LLM-toepassingen in productie te brengen. In deze blogpost onderzoeken we in hoeverre de kwaliteit van RAG-toepassingen automatisch kan gemeten worden.
-
GraphRAG – Vers une génération augmentée par les graphes de connaissances
Les systèmes RAG (Retrieval-Augmented Generation) ont permis aux grands modèles de langage (LLM) de s’appuyer sur des données fiables. Mais ils restent limités, entre autres, dans leur capacité à contrôler les hallucinations. C’est là que GraphRAG entre en jeu : en combinant les LLM avec des graphes de connaissances, il améliore la précision, la transparence et la capacité de raisonnement des modèles.
-
Évaluation d’un système génératif de questions-réponses
Les frameworks d’évaluation des applications RAG permettent une évaluation systématique de la qualité des systèmes génératifs de questions-réponses. Ils permettent de mesurer différents aspects, tels que la capacité à récupérer des informations pertinentes (retrieval) et la qualité des réponses générées. Ces métriques sont essentielles pour comprendre les faiblesses d’un système RAG et apporter les ajustements nécessaires.
-
Evalueren van een generatief vraag-antwoordsysteem
Frameworks voor het evalueren van RAG toepassingen laten toe om de kwaliteit van generatieve vraag-antwoordsystemen systematisch te beoordelen. Ze voorzien een manier om verschillende aspecten te meten, zoals het vermogen om relevante informatie op te halen (retrieval) en de kwaliteit van de gegenereerde antwoorden. Dergelijke metrieken zijn cruciaal om inzicht te krijgen in de eventuele zwakke punten van een RAG…
Keywords:
analytics Artificial intelligence big data blockchain BPM chatbot cloud computing cost cutting cryptography data center data quality EDA egov Event GIS governance Information management Machine Learning Managing IT costs methodology Mobile Open Source Privacy Productivity quantum computing Security social software design software engineering standards